一、静态模型 vs 动态进化
大多数人对AI的认知停留在"训练好、部署、使用"的线性流程上。模型一旦部署,能力就固定了。这种静态模式在图像识别、语音合成等场景中或许可行,但在工业生产中却行不通——因为工业环境本身就是动态变化的。
加气混凝土行业的实际情况最能说明问题:
- 季节变化:夏季高温高湿与冬季低温干燥,蒸压养护的工艺参数完全不同
- 原料波动:不同批次的石灰、水泥、粉煤灰的活性存在差异
- 设备老化:阀门响应特性、传感器精度会随时间漂移
- 工况迁移:产品规格切换、产能调整带来全新的运行模式
面对这些变化,一个静态的AI模型必然性能退化。工业AI Agent必须具备自我进化的能力,而这正是"数据飞轮"的核心价值所在。
二、数据飞轮的四阶段闭环
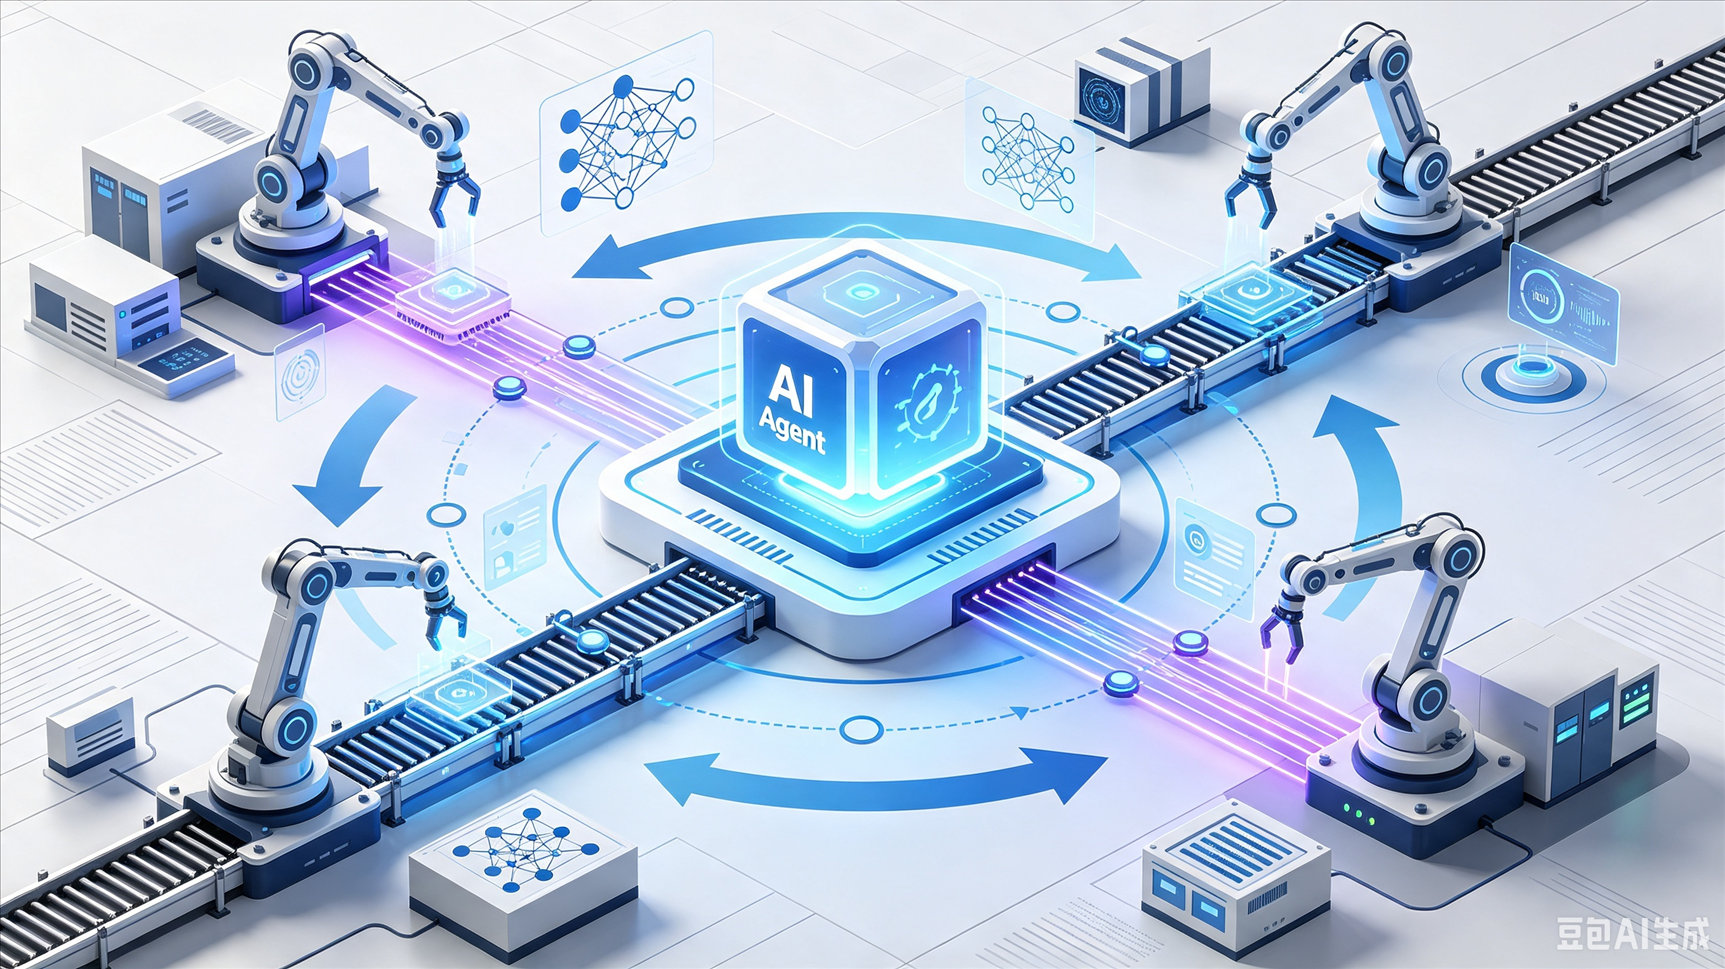
数据飞轮(Data Flywheel)是一个持续的正向循环:数据越多 → 模型越好 → 效果越佳 → 使用越多 → 数据越多。在工业场景中,这个循环具体表现为:
阶段一:数据采集(感知层)
一切进化的起点是数据。贵州迪森的实践表明,工业数据采集需要在三个维度上发力:
- 覆盖度:温度、压力、流量、液位、电流、振动……关键工艺参数一个都不能少
- 频率:蒸汽调节是秒级控制,传感器采集频率需达到1Hz以上
- 质量:异常值检测、缺失值补全、时间戳对齐,保证数据可用
值得注意的是,操作日志和运行记录同样重要——什么时候操作工手动干预了AI的决策?调整了什么参数?这些"人在回路"的行为数据,是模型进化的关键养分。
阶段二:模型训练(认知层)
采集到的数据经过清洗和标注后,进入模型训练流程:
- 离线训练:每周/每月用累积的新数据重新训练模型
- 增量学习:在原有模型基础上微调,保留已学知识,吸收新模式
- 多任务学习:同时优化能耗、质量、效率等多个目标
贵州迪森在这方面的做法值得借鉴——他们不是让AI记住"标准答案",而是让AI从大量历史数据中自我发现最优解。通过对各个工厂数据的提炼、分析和训练,AI系统学会了识别不同工况下的最佳操作模式。
阶段三:部署推理(执行层)
训练好的模型经过压缩量化后部署到边缘设备:
- A/B测试:新旧模型并行运行,对比效果
- 灰度发布:先在一个班组或一条产线试用,验证后再推广
- 人工兜底:AI的建议必须经人工确认(或设定安全边界自动执行)
关键设计原则:AI决策必须可解释、可追溯。当操作工看到AI输出的配汽指令时,需要知道"为什么这么调"——这既是为了建立信任,也是为了在出现问题时能够复盘。
阶段四:反馈优化(进化层)
这是数据飞轮中最容易被忽视但最重要的环节。AI决策执行后,需要将结果反馈给训练系统:
- 结果评估:AI指令执行后,实际能耗是多少?质量是否达标?
- 偏差分析:模型预测值与实际值之间的偏差有多大?趋势是什么?
- 人工标注:操作工的修正操作作为"真值"反馈给模型
正是这个反馈环节,让AI系统从"开环控制"变为"闭环进化"。
三、工业数据飞轮的独特挑战
消费互联网的数据飞轮(如推荐系统)可以做到天级迭代,但工业场景面临以下独特困难:
| 挑战 | 表现 | 应对策略 |
|---|---|---|
| 数据稀疏 | 异常工况样本少 | 数据增强、迁移学习、合成样本 |
| 标注成本高 | 需要专家对操作结果评估 | 半监督学习、自动标注管道 |
| 安全约束 | 不能随意探索新策略 | 安全边界约束、离线仿真验证 |
| 概念漂移 | 设备老化导致数据分布变化 | 在线检测、自适应重训策略 |
贵州迪森的解决方案是通过多工厂数据汇聚来缓解数据稀疏问题——单个工厂可能一年只遇到几次特殊工况,但10个工厂的数据加起来,样本量就足够训练一个鲁棒的模型。
四、从"人工智障"到"AI老师傅"的进化之路
任何一个工业AI系统在初部署阶段都不会太好用——这很正常。关键在于数据飞轮的转速:
- 第1个月:AI频繁给出不合理建议,操作工需要大量人工修正
- 第3个月:AI掌握常见工况,修正频率降低
- 第6个月:AI在大多数场景下优于人工,操作工开始信任系统
- 第12个月:AI积累了大量"边缘案例"经验,成为一个真正的"AI老师傅"
这就是数据飞轮的力量。AI的能力不是写死的,而是"长"出来的。它像一个不断成长的学徒,从观察、模仿、犯错、修正中逐步成为一个经验丰富的专家。
五、结语
工业AI Agent的真正壁垒不在于初始模型的精度有多高,而在于数据飞轮的转速有多快。一个每周迭代一次的AI系统,半年后一定碾压一个部署后就从未更新的系统。
贵州迪森在加气混凝土行业的实践已经证明了这一点——通过"数据采集→模型训练→部署推理→反馈优化"的完整闭环,AI系统能够持续适应工况变化、不断逼近理论最优值。这不仅是技术的胜利,更是工程思维的胜利:不以"模型越复杂越好"为目标,而以"数据飞轮转得越快越好"为准绳。