一、为什么工业场景离不开边缘计算?
在消费互联网领域,"数据上云"是主流范式——拍照上传、视频流媒体、在线办公,云端的几毫秒延迟对用户体验影响不大。但在工业场景中,情况截然不同。
以加气混凝土行业的蒸压养护环节为例:一块砖坯从常温进入蒸压釜后,需要在特定温升速率下完成水热合成反应。温度上升过快会导致砖坯开裂,过慢则延长周期、浪费蒸汽。这个过程的控制窗口通常只有几分钟,任何网络抖动或云端延迟都可能导致产品质量问题。
这就是工业AI Agent必须部署在边缘的核心原因:
| 需求 | 云端方案 | 边缘方案 |
|---|---|---|
| 推理延迟 | 50-200ms(含网络) | 1-10ms |
| 数据带宽 | 受限于网络 | 本地处理,无瓶颈 |
| 离线可靠性 | 断网即失效 | 本地独立运行 |
| 数据隐私 | 需传输到外部 | 本地闭环 |
二、边云协同架构:各司其职的智能分层
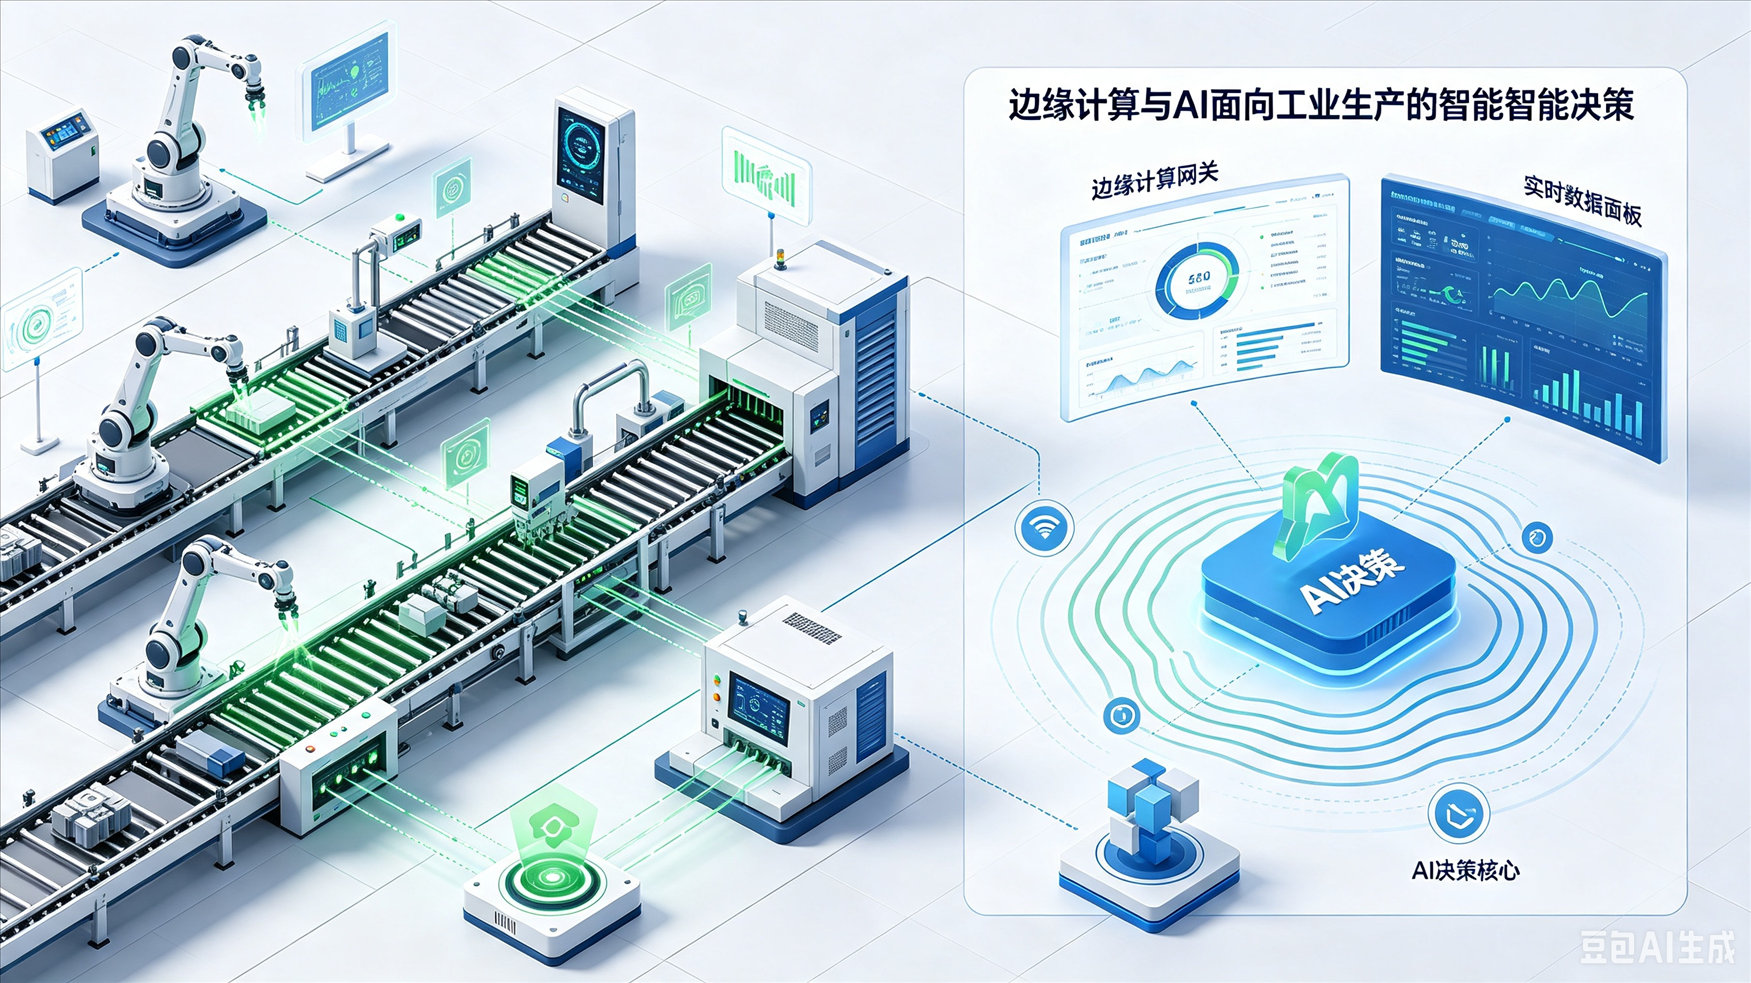
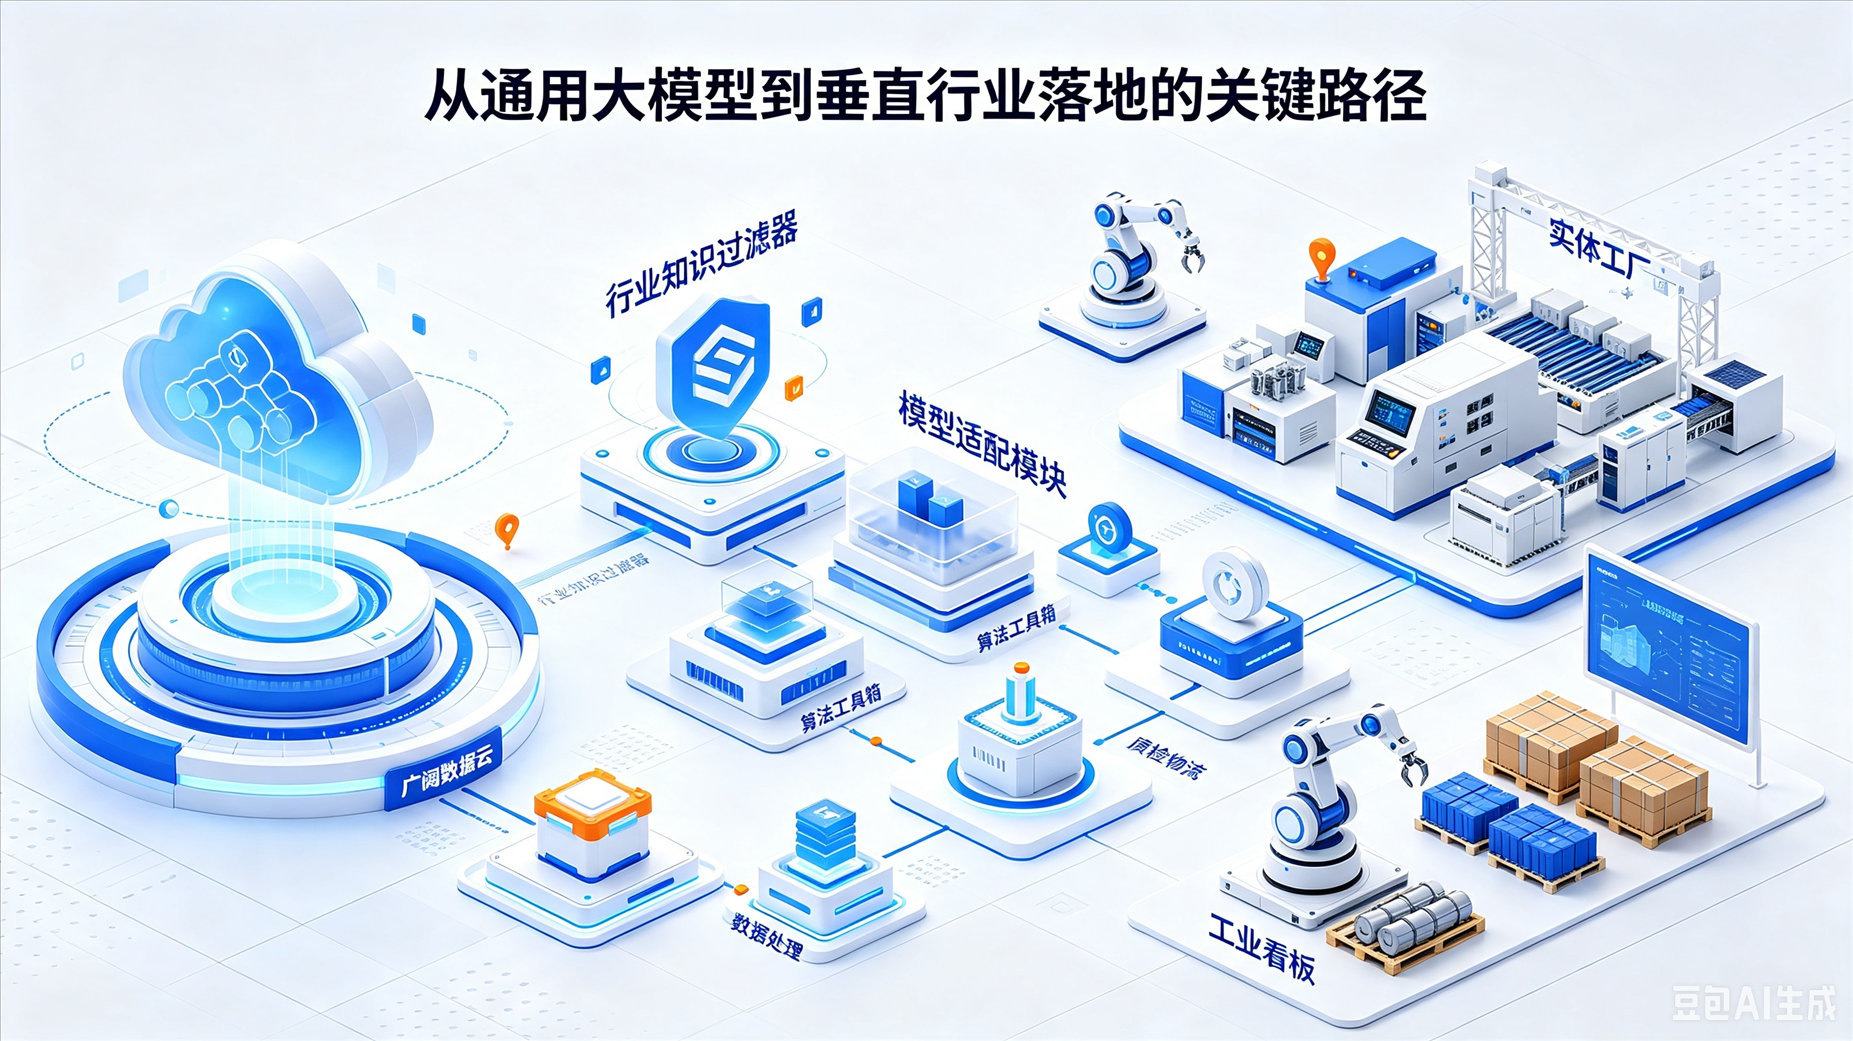
边缘计算并不意味着完全抛弃云端。真正高效的工业AI系统采用的是边云协同架构——边缘和云端各自承担最适合自己的角色。
边缘层:实时控制与推理
贵州迪森的节能AI系统在边缘层的设计极具代表性:
- 数据采集:通过PLC和传感器网关,实时采集蒸压釜的温度、压力、液位等数十个参数
- 实时推理:边缘设备加载轻量化模型,在毫秒级内完成推理,输出配汽指令
- 本地执行:推理结果直接写入DCS系统,控制蒸汽调节阀的开度和时序
边缘层的核心原则是"不依赖外部网络"。即使与云端断开连接,边缘AI仍然能保证生产正常运行。
云端层:训练与优化
云端负责边缘无法承担的重计算任务:
- 模型训练:汇聚多个工厂的历史数据,训练和更新行业模型
- 跨厂对标:对比不同产线的能耗数据,识别最佳实践
- 全局优化:综合分析季节变化、原材料批次差异等因素,优化工艺参数
协同机制
边云之间通过异步通信实现协同:
云端训练新模型 → 压缩量化 → 下发到边缘边缘采集数据 → 上传到云端 → 加入训练集
这种机制的巧妙之处在于:边缘的实时决策不受云端影响,但云端的全局优化能力又能持续赋能边缘。
三、实时控制与模型推理的优化策略
工业AI Agent面临的核心技术挑战,是如何在有限的边缘设备算力下,实现高精度的实时推理。以下是几个关键优化策略:
1. 模型轻量化
在工业边缘设备(通常为ARM架构的工控机或嵌入式设备)上运行大型深度神经网络是不现实的。常见的做法包括:
- 模型剪枝:移除对推理结果影响较小的连接和神经元
- 量化压缩:将FP32模型量化为INT8,推理速度提升3-4倍,精度损失控制在1%以内
- 知识蒸馏:用大模型训练小模型,让小模型继承大模型的"智慧"
2. 时序预测的优化策略
工业过程控制本质上是时间序列问题。以蒸汽用量预测为例:
- 滑动窗口机制:取最近N个时间步的数据作为输入,而非全量历史数据
- 多尺度特征提取:同时考虑秒级(实时波动)、分钟级(操作变化)、小时级(工艺阶段)的特征
- 自适应采样:在稳态工况下降低采样频率,在工况变化时提高采样密度
3. 控制指令的平滑处理
AI模型输出的原始控制信号往往是离散的或跳变的,直接作用于执行机构可能导致阀门频繁动作。贵州迪森的系统采用了一套指令平滑算法:
- 对AI输出进行低通滤波,消除高频抖动
- 设置死区阈值,避免微小偏差触发调节
- 预测未来N步的最优控制轨迹,而非单步决策
四、实际案例:蒸压釜配汽的智能控制
在加气混凝土行业,蒸压养护环节的蒸汽消耗占整个工厂能耗的40%-60%,是最有价值优化的环节。
贵州迪森在边缘部署的AI Agent实现了以下功能:
- 实时工况识别:通过传感器数据判断当前处于"升温期""恒温期"还是"降温期",不同阶段采用不同的控制策略
- 动态配汽优化:根据釜内温度梯度、外界气温、砖坯规格等参数,实时计算最优蒸汽流量
- 预测性调节:提前预测下一阶段的蒸汽需求,避免滞后调节带来的能量浪费
实施效果:蒸汽单耗下降8%-15%,产品合格率提升3%-5%。这些收益的取得,正得益于边缘计算+AI架构所提供的实时决策能力。
五、展望:从单机智能到产线协同
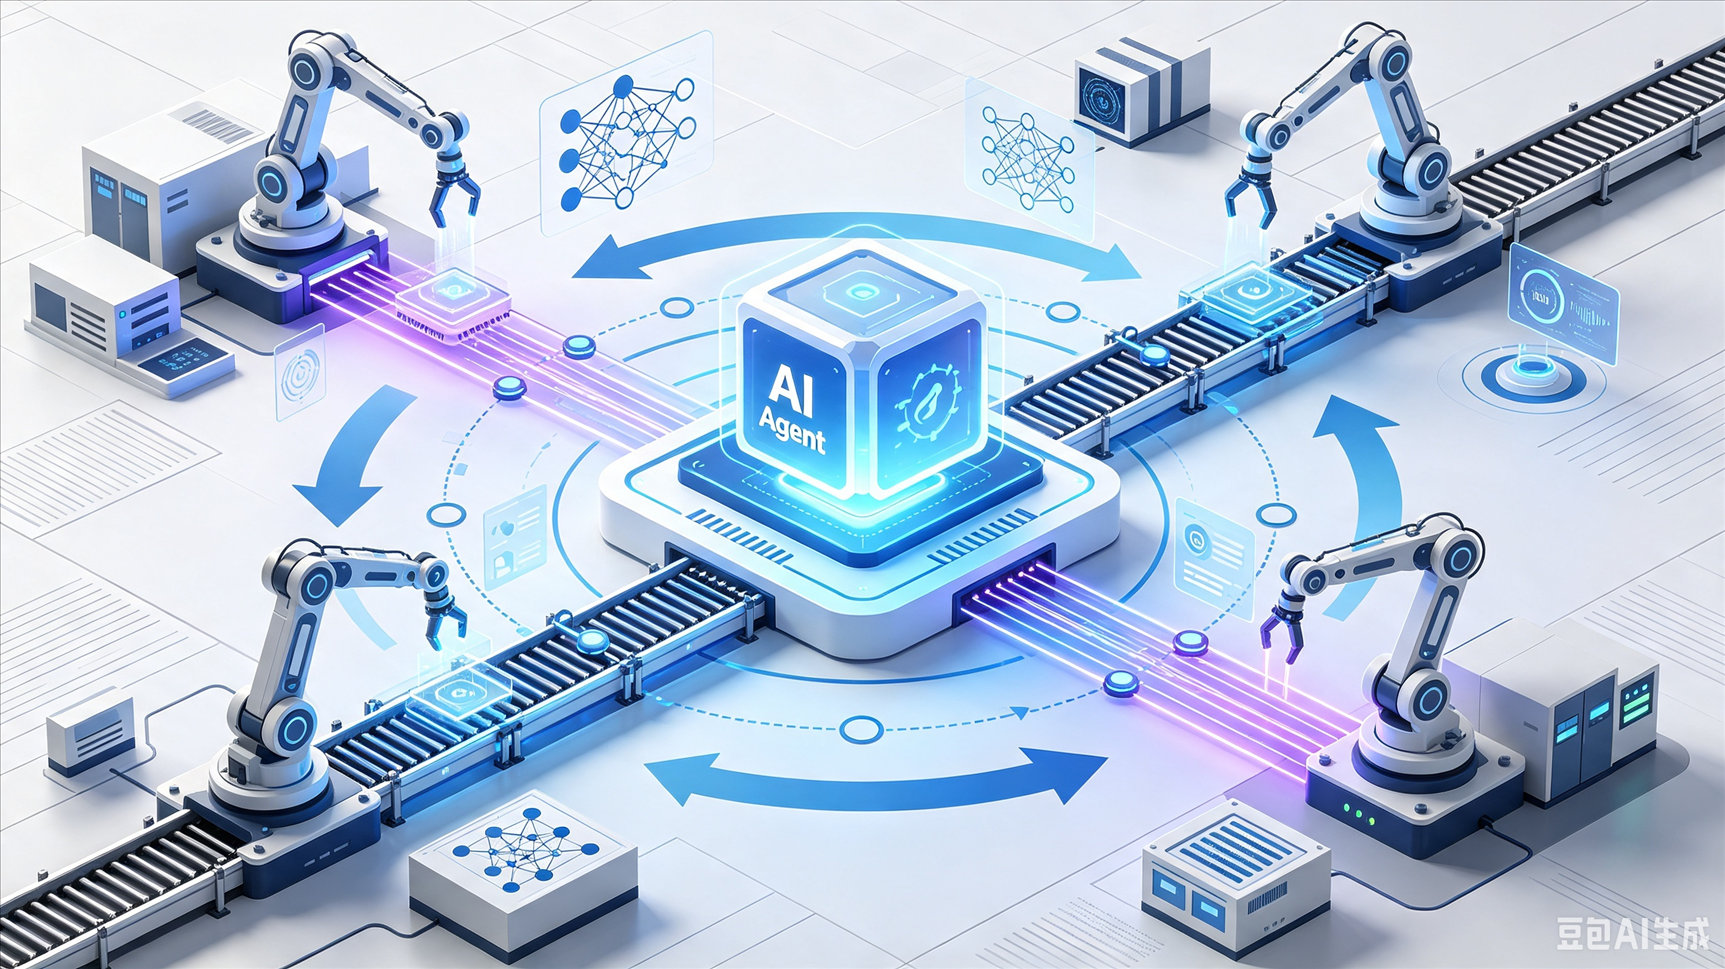
当前大多数工业AI Agent还停留在"单点优化"阶段——优化一台设备、一条产线。未来的方向是产线级协同智能:
- 多条产线的边缘节点之间共享状态信息
- 上游工序的AI决策影响下游工序的参数设定
- 通过分布式协商实现全局能耗最优
边缘计算+AI的组合,正在为工业生产注入前所未有的智能化能力。这不是一个"要不要做"的问题,而是"怎么做"和"做多快"的问题。