一、通用大模型的"最后一公里"困境
2024年以来,大语言模型(LLM)技术突飞猛进,GPT-4、Claude、Llama等通用大模型展现出令人惊叹的推理和对话能力。然而在工业场景中,这些通用模型却面临着显著的"水土不服"——它们可以写出优美的诗歌,却无法理解加气混凝土生产线上的蒸压釜配汽曲线;它们能通过律师资格考试,却不知道如何根据窑温变化调整锅炉负荷。
这种落差背后,是一个核心问题:工业领域的知识壁垒极其深厚,通用大模型缺乏垂直行业的"know-how"编码。以加气混凝土行业为例,一条生产线涉及原料配比、搅拌浇注、静停切割、蒸压养护等数十道工序,每道工序的工艺参数都依赖数十年的经验积累。这些经验从未被系统性地数字化,更遑论被大模型学习。
二、行业know-how:工业AI Agent的护城河
工业AI Agent要真正落地,首先需要解决"知识注入"问题。这不是简单的文档喂入或RAG(检索增强生成),而是对行业机理模型的深度编码。
案例:贵州迪森节能技术有限公司的实践
贵州迪森在加气混凝土行业的AI实践中,走的正是一条"从数据中来,到数据中去"的路线。他们没有试图让通用大模型理解蒸压养护的物理化学过程,而是通过以下方式构建行业专属知识体系:
- 传感器数据化:在生产线关键节点部署大量传感器,将温度、压力、湿度等物理量实时采集,形成数字化的"操作轨迹"。
- 经验算法化:将老师傅的配汽操作经验转化为独有算法,让AI系统学习"什么工况下应该开多大蒸汽阀"。
- 数据闭环训练:通过多工厂、多产线的数据积累,持续训练行业模型,使其越来越"懂行"。
这种"从传感器到决策"的完整链路,正是工业AI Agent区别于通用ChatBot的本质所在。
三、边缘计算架构:解决工业场景的实时性难题
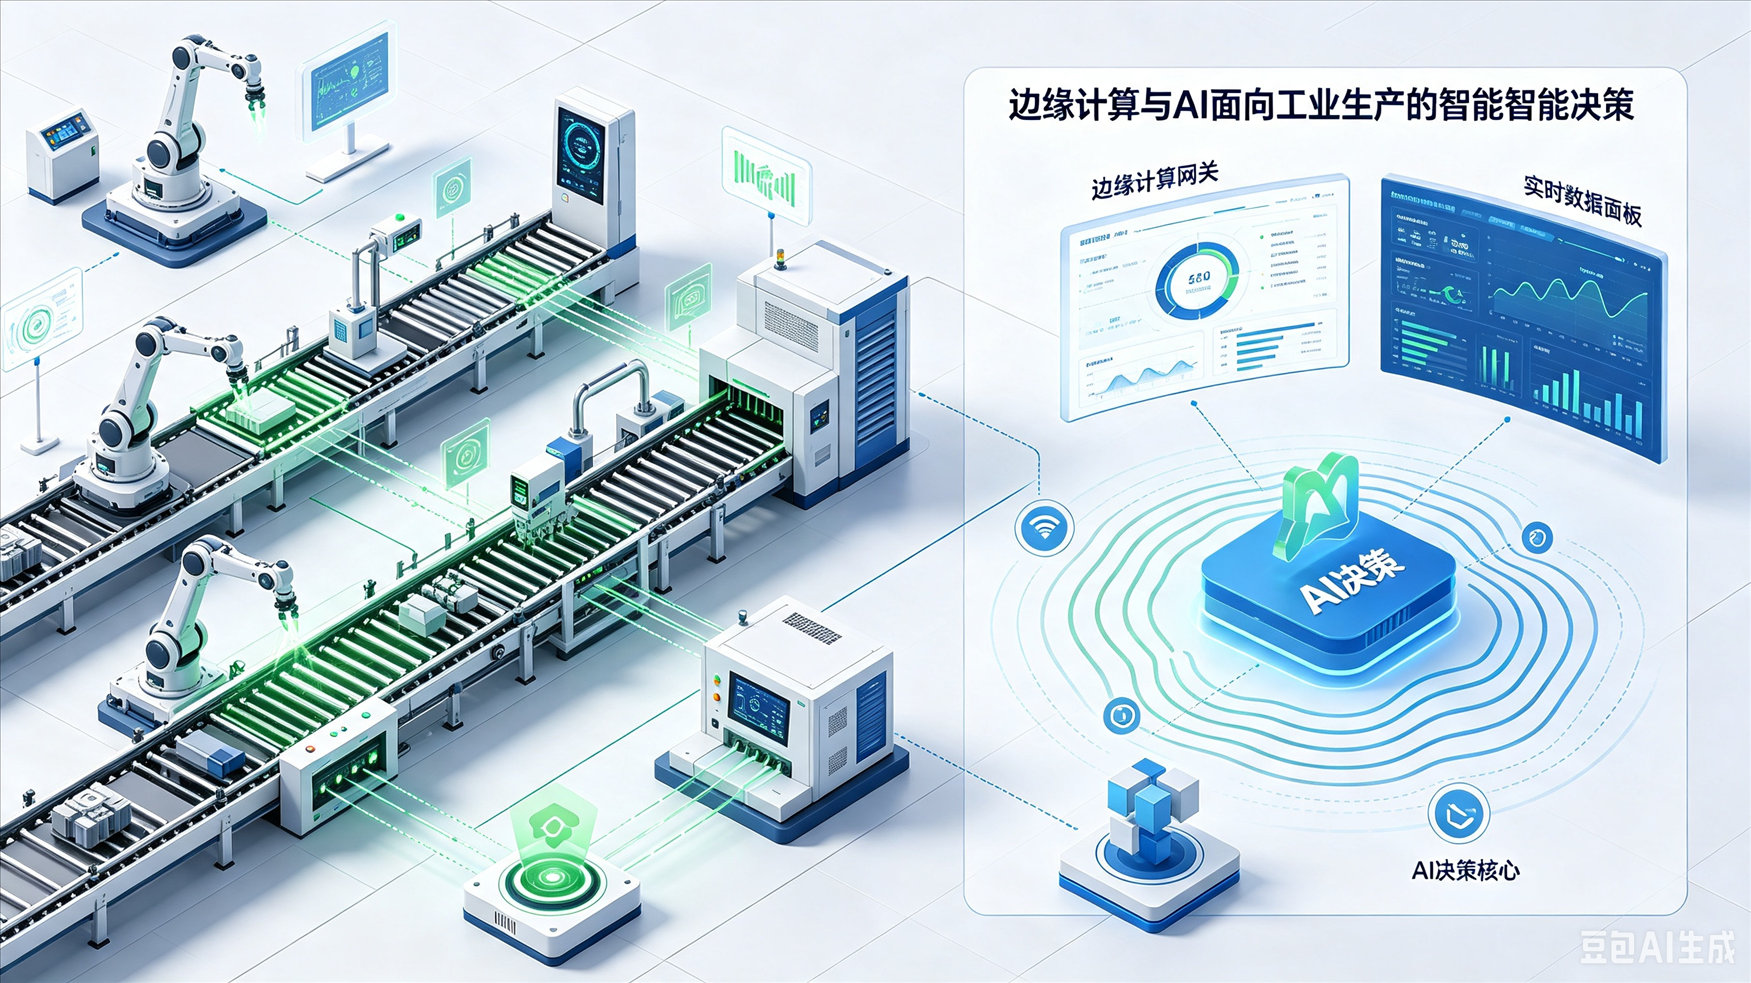
工业环境对AI系统的实时性要求极高。一条加气混凝土生产线每分钟都在发生物理化学反应,延迟几秒的决策就可能导致整釜产品报废。如果将数据上传到云端处理,网络延迟、带宽瓶颈都会成为致命问题。
因此,工业AI Agent必须采用边缘计算架构:
- 就近处理:在生产线设备旁部署边缘计算节点,数据不出车间即可完成推理
- 本地决策:AI推理结果直接转化为控制指令,通过PLC/DCS系统执行
- 断网容灾:即使与云端通信中断,边缘节点仍能独立运行,保证生产连续性
贵州迪森的节能AI系统正是采用了这一架构——在每一条生产线旁部署边缘计算设备,实时处理传感器数据,在毫秒级时间内输出配汽和锅炉操作指令,真正实现了"数据在设备侧处理、决策在现场完成"。
四、从"经验驱动"到"数据+AI驱动"的范式转变
传统工业生产高度依赖"老师傅经验"——一位优秀的配汽工需要5-10年的经验积累才能准确判断最佳操作时机。这种模式的局限性显而易见:经验难以复制、人员流动带来知识断层、人为因素导致质量波动。
工业AI Agent带来的核心变革是将隐性经验显性化、可量化、可复制:
| 维度 | 经验驱动 | 数据+AI驱动 |
|---|---|---|
| 决策依据 | 个人直觉、经验 | 传感器数据+算法模型 |
| 一致性 | 因人、因时而异 | 稳定、可复现 |
| 优化速度 | 年/月级 | 天/小时级 |
| 传承方式 | 师徒制 | 模型部署 |
| 覆盖范围 | 单点/单人 | 全产线/多工厂 |
贵州迪森通过AI智能分析系统,对各个工厂的数据进行提炼、分析、训练,每天输出最优的工艺及能耗操作指令。这不仅提升了生产效率,更重要的是将最佳实践固化到AI系统中,使每一个工厂都能复制"金牌操作工"的水平。
五、落地路径总结
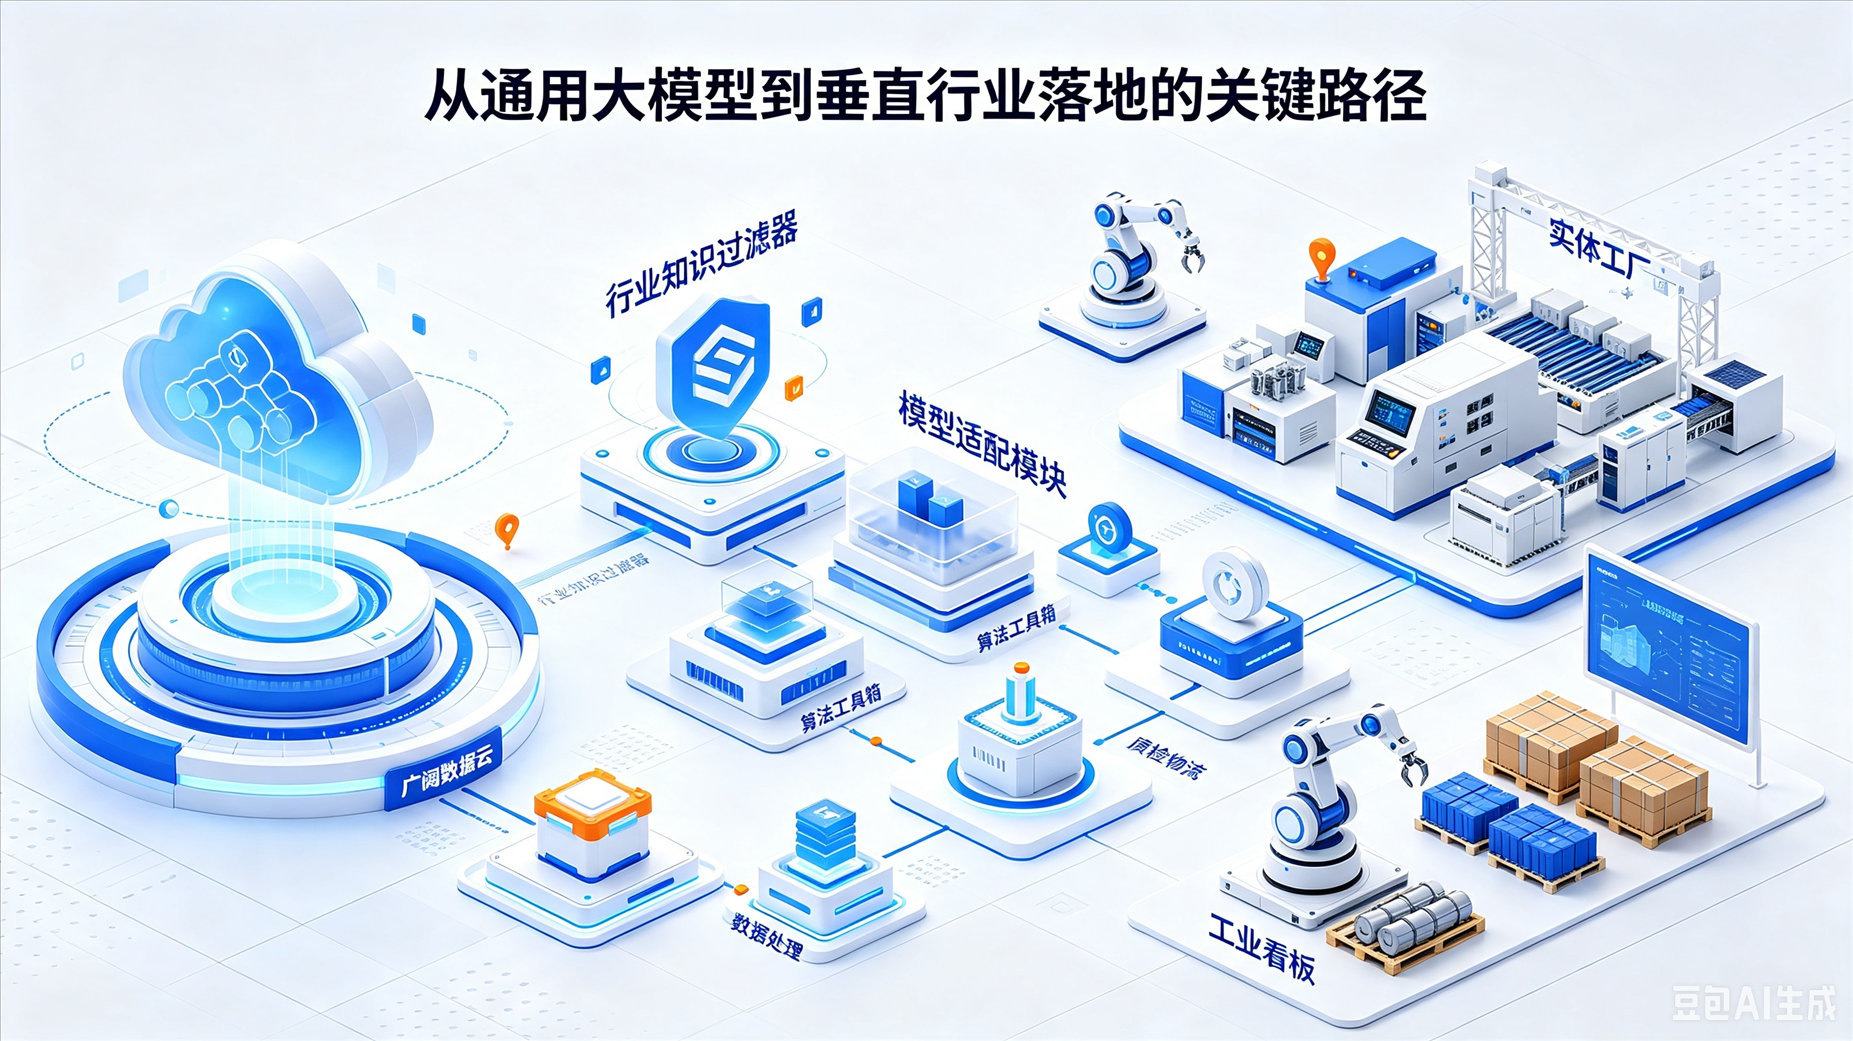
从通用大模型到垂直行业AI Agent的落地,可以总结为以下关键路径:
- 行业知识结构化:将隐性经验转化为可编码的规则和数据
- 边缘+云端协同:边缘侧负责实时推理,云端负责模型训练和迭代
- 数据飞轮启动:通过持续的数据采集和反馈,让模型越用越聪明
- 人机协同闭环:AI提供决策建议,人工监督和修正,形成良性循环
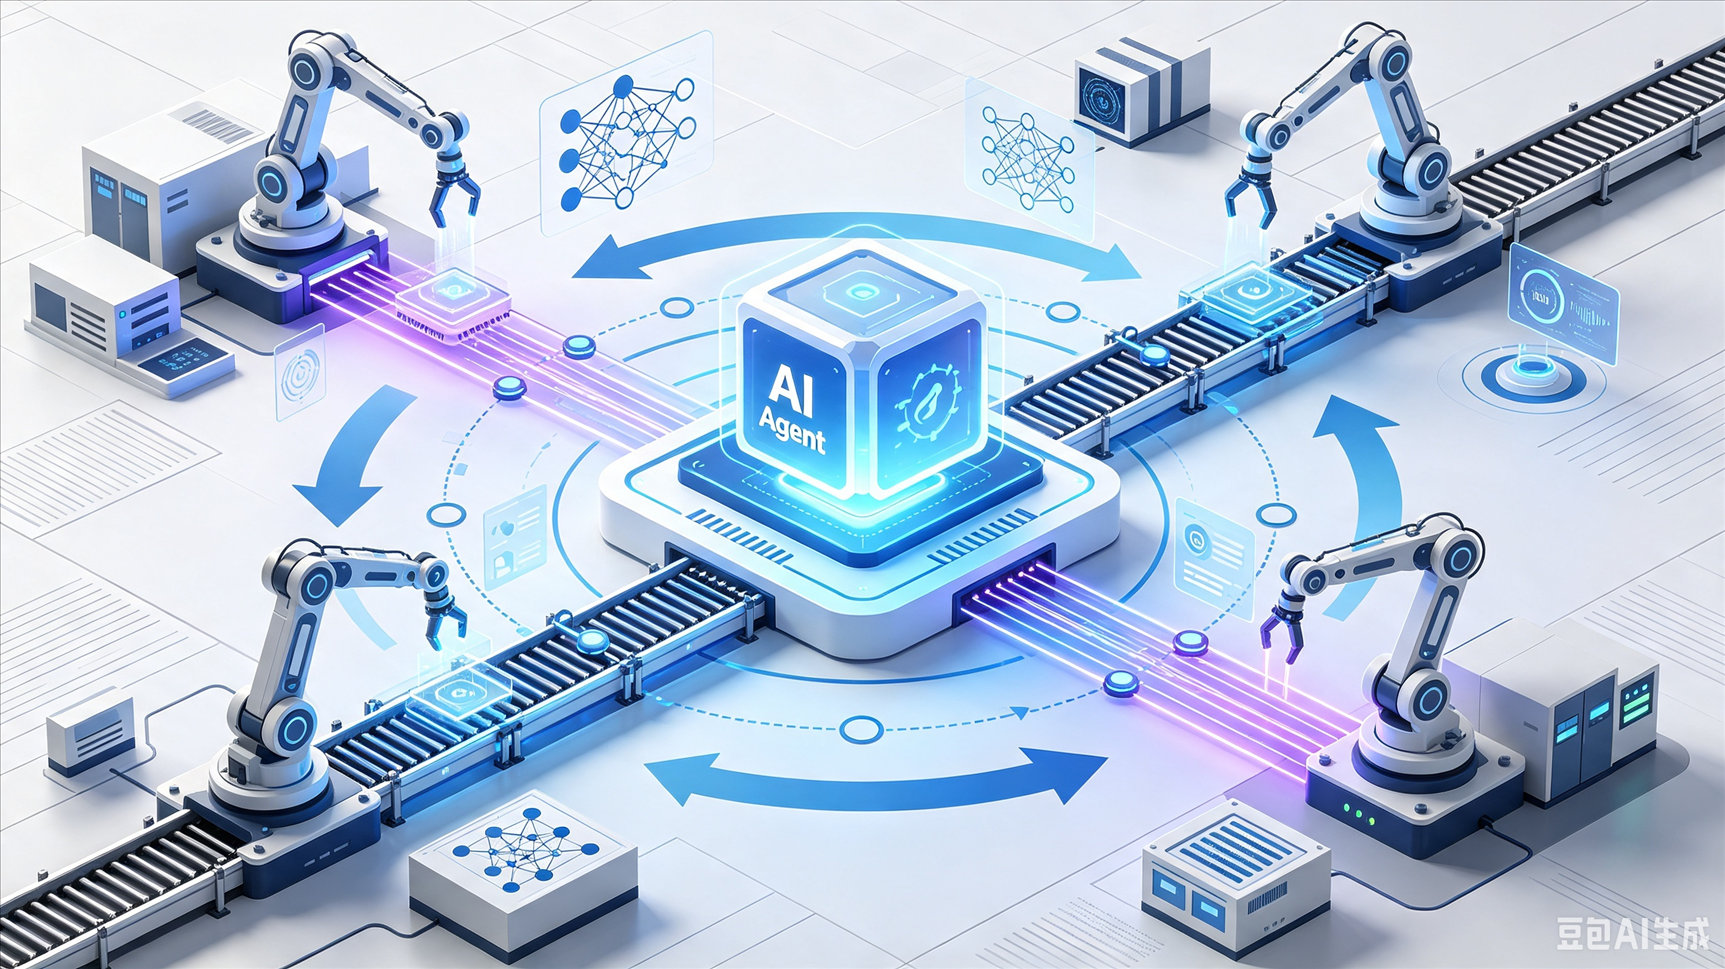
工业AI Agent不是要替代工人,而是要将行业know-how与AI技术深度融合,让每个工厂都拥有一个不知疲倦的"AI老师傅"。